研修動画のナレーション、アプリの読み上げ機能、AIキャラクターとの音声会話。音声合成AI(TTS:Text-to-Speech)を使いたい場面は増えていますが、サービスの比較記事を読んでも、自社のアプリに組み込むときに何で選べばいいのかは意外と書かれていません。
組み込む側が本当に知りたいのは、声の良し悪しより先に、月にいくらかかるのか、商用で使ってよいのか、表記は必要か、話し始めるまで何秒待たせるのかといった、設計と運用の話です。
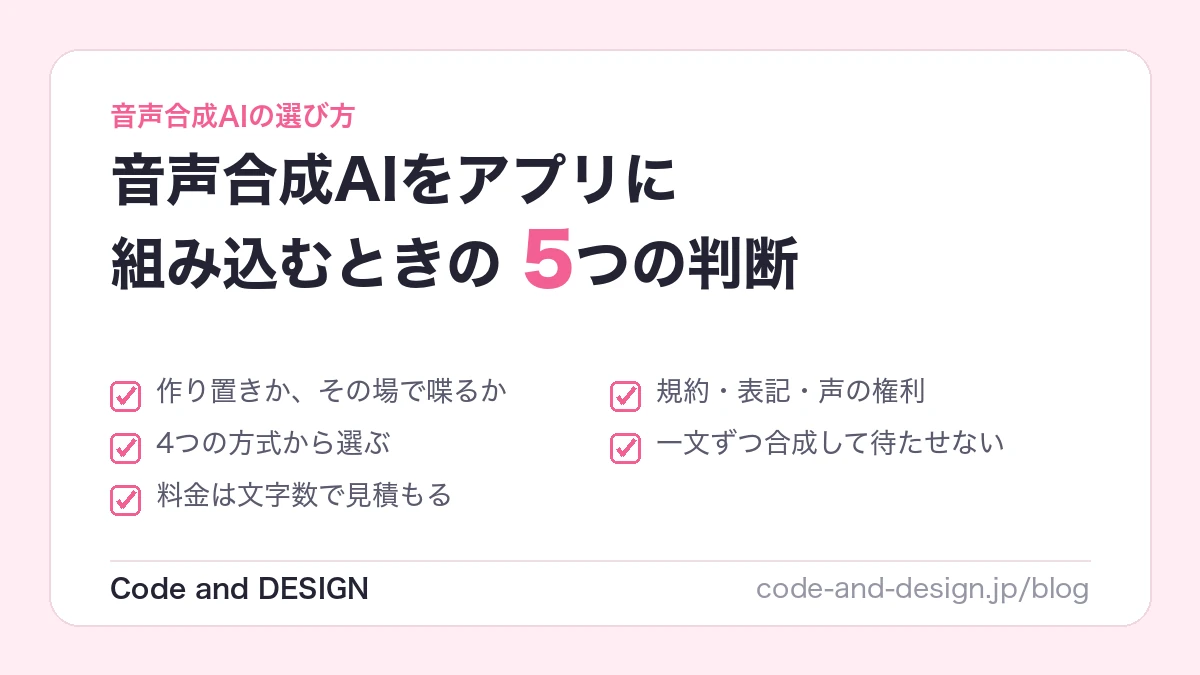
この記事では、音声合成を組み込むときの判断を5つに分けて整理します。料金は2026年10月時点の各社の公式価格をもとにした試算で、当社が開発・運営している音声つきAIアプリでの実装例もあわせて紹介します。
📌 この記事の3行まとめ
① 最初に「作り置き」か「その場で喋る」かを決める。選ぶ基準がまったく違う
② 料金は「月の文字数×単価」で先に見積もる。作り置きはほぼ誤差、利用者が増えるほど喋るアプリでは最大の変動費になる
③ その場で喋るアプリは、一文ずつ合成して、できた順に再生するのが基本。声の権利と規約の確認は、作る前に済ませる
判断1:「作り置き」か「その場で喋る」か
音声合成の使い方は、大きく2つに分かれます。
| 作り置き | その場で喋る | |
|---|---|---|
| 例 | 研修動画・マニュアル・案内放送・ナレーション・定型の通知 | AIキャラクターとの会話・音声アシスタント・回答の読み上げ |
| 読ませる文章 | 事前に決まっていて、人が確認できる | その場で生成され、事前に確認できない |
| 重視すること | 声の品質、読みとアクセントの正確さ、修正のしやすさ | 話し始めるまでの速さ、1回あたりの単価、同時に使う人数 |
| 費用の性質 | 制作のたびに一度だけ | 利用者と会話の数に比例して毎月かかる |
| 向く作り方 | 高品質なクラウドTTSで生成し、音声ファイルとして配る | 一文ずつ合成するクラウドTTS、または端末内での合成 |
作り置きなら、少し高価でも品質の高い声を選び、読み間違いは人が聞いて直せます。一方、その場で喋るアプリは、遅さと単価がそのまま体験と利益を左右するため、選び方が変わります。どちらの用途かを最初に決めるだけで、比較すべき項目が半分になります。
判断2:4つの方式から選ぶ
音声合成の選択肢は、2026年時点で大きく4つの方式に分けられます。
| 方式 | 主なサービス・技術 | 料金の形 | 通信 | 向いている用途 |
|---|---|---|---|---|
| クラウドTTS(API) | Google Cloud Text-to-Speech、Amazon Polly、Azure AI Speech | 文字数に応じた従量課金(無料枠あり) | 必要 | 作り置き全般、業務システム、多言語の案内 |
| 生成AI型の音声生成 | ElevenLabs、Gemini TTSなど | 文字数・トークン・月額プラン | 必要 | 感情表現の豊かなナレーション、声のデザイン |
| キャラクター音声エンジン | VOICEVOX、AivisSpeechなど | 無料(クレジット表記などの条件あり) | 不要(PC・サーバー・アプリの中で動く) | キャラクター、ゲーム、動画、端末内での合成 |
| 端末の標準音声合成 | iOSのAVSpeechSynthesizer、AndroidのTextToSpeech | 無料 | 不要 | 読み上げ機能、アクセシビリティ |
クラウドTTSは、安定していて多言語に強く、読みを指定するSSML(音声合成マークアップ言語)にも対応しています。日本語の声は、Google Cloud Text-to-SpeechならStandard・WaveNet・Neural2・Chirp 3: HDの各世代に、Amazon PollyならStandard(Mizuki・Takumi)とNeural(Takumi・Kazuha・Tomoko)にあります。ただしPollyの「Generative」「Long-Form」の世代には、2026年10月時点で日本語の声がありません。
生成AI型の音声生成は、文脈に合わせた抑揚や感情の表現が得意で、声をデザインしたり、本人の同意のもとで声を複製(クローン)したりできるサービスもあります。一方で、読みやアクセントを細かく指定しにくい場合があり、モデルの入れ替わりも速い分野です。たとえばOpenAIは、音声合成専用のモデル(tts-1、tts-1-hd、gpt-4o-mini-tts)を2027年1月6日に提供終了すると告知しています。長く運用するアプリでは、提供終了の予定と移行先を確認してから選びます。
キャラクター音声エンジンは、日本語に特化した無料の音声合成です。VOICEVOXは、商用・非商用を問わず無料で使え(クレジット表記が必要)、アプリに組み込むためのライブラリ「VOICEVOX CORE」が、Windows・Mac・Linuxに加えてiOS・Android向けにも提供されています。端末の中で合成できるので、通信もAPI料金も要りません。ただし、キャラクターごとに利用規約があり、なかにはソフトや音声モデルの再配布を禁じているエンジンもあるため、アプリに組み込めるかは規約で確認します。
端末の標準音声合成は、無料・通信なしで多くの言語を読み上げられます。声の表現力はほかの方式に及びませんが、回答の読み上げやアクセシビリティの用途なら十分です。
判断3:料金は「月の文字数×単価」で先に見積もる
クラウドの音声合成は、基本的に読ませた文字数に応じた従量課金です。主なサービスの公式価格(2026年10月時点)は次のとおりです。
| サービス | 100万文字あたりの価格 | 毎月の無料枠(目安) |
|---|---|---|
| Google Cloud Text-to-Speech | Standard・WaveNet 4ドル、Neural2 16ドル、Chirp 3: HD 30ドル | Standard・WaveNet 400万文字、Neural2・Chirp 3: HD 各100万文字 |
| Amazon Polly | Standard 4ドル、Neural 16ドル | Standard 500万文字(Neuralは最初の12か月に100万文字) |
| Azure AI Speech | Neural 15ドル、Neural HD 22ドル | 無料プラン(F0)で50万文字 |
| ElevenLabs(API従量課金) | 最新モデル(v4)80ドル、低遅延モデル(Flash・v4 Turbo)40ドル | 1万文字(無料プランは非商用) |
(各社の公式料金ページの米ドル価格。Gemini TTSのようにトークン単位で課金されるサービスもあります。Google Cloudでは、SSMLのタグ(<mark>を除く)や空白・改行も文字数に数えられます。)
この単価を、2つの使い方に当てはめてみます。為替は1ドル150円で概算しています。
例1:研修動画(作り置き)
- 月20本 × 1本3,000字 = 月6万字
- 最も高価な部類のChirp 3: HD(100万文字30ドル)でも、6万字なら約1.8ドル(約270円)。そもそも無料枠(月100万文字)に収まります
作り置きの用途では、音声合成の料金はほぼ誤差です。比べるべきは料金ではなく、声の品質と、読み間違いを直す手間です。
例2:AIキャラクターアプリ(その場で喋る)
- 1日の利用者1,000人 × 1人20回の返答 × 1回60字 = 1日120万字 = 月3,600万字
| 単価(100万文字あたり) | 月額の目安 | 利用者が1万人になると |
|---|---|---|
| 16ドル(Neural2・Pollyのニューラル音声) | 約576ドル(約8.6万円) | 約5,760ドル(約86万円) |
| 30ドル(Chirp 3: HD) | 約1,080ドル(約16万円) | 約10,800ドル(約162万円) |
| 80ドル(ElevenLabs v4) | 約2,880ドル(約43万円) | 約28,800ドル(約432万円) |
| 0ドル(端末内で合成) | 0円 | 0円 |
その場で喋るアプリでは、音声合成が、利用者の数に比例して増える最大級の変動費になりえます。しかも無料アプリや定額課金のアプリでは、喋れば喋るほど赤字が膨らむ構造になりかねません。対策は、端末内で合成する方式を選ぶ、よく使う定型文をキャッシュする、1回の返答を短くする、利用量に応じたクレジット制にする、といった設計で、作り始める前に決めておく必要があります。
判断4:商用利用の条件、表記、声の権利
サービスとキャラクターの規約を確認する
音声合成は、「商用で使えるか」「表記が必要か」「何に使ってはいけないか」がサービスやキャラクターごとに違います。代表的な確認点は次のとおりです。
- 無料プランの扱い:ElevenLabsは、無料プランでの生成物を非商用に限っています(商用利用は有料プランから)
- クレジット表記:VOICEVOXは商用でも無料ですが、VOICEVOXを使ったことが分かるクレジット表記が必要です。たとえば「ずんだもん」の音声は「VOICEVOX:ずんだもん」と表記し、アプリでは紹介画面などに記載します。表記なしで商用利用する場合は、1キャラクターごとに有償の契約が必要と定められています
- 禁止されている用途:ずんだもんの規約では、政治・宗教活動、特定の個人や団体を批判または応援する目的、情報商材、意図的に誤解を招く内容などへの利用が禁止されています。利用者が自由に喋らせられるアプリでは、こうした用途に使われないための対策も考えます
- AI音声であることの表示:OpenAIの音声合成のように、利用者に対して「AIが生成した声であること」を明示するよう求めるサービスもあります。規約上の義務がなくても、表示しておくのが安全です
(2026年10月時点の各サービス・キャラクターの規約に基づく概要です。規約は改定されることがあるため、採用時に原文を確認してください。)
実在の人の声を使うとき
社員や声優、タレントの声を音声合成に使う場合は、さらに慎重な判断が必要です。日本には「声」そのものを守る法律はありませんが、2026年に入って整理が大きく進みました。
- 法務省の検討会が2026年8月に公表した取りまとめ報告書「生成AIによるパブリシティ権侵害等に関する解釈指針」は、パブリシティ権で守られる「肖像等」に、人格の象徴である人の「声」も含まれると整理しました。さらに、実在の著名人の声を容易に生成できることを売りにして生成AIを有償で提供する場合は、提供した事業者自身がパブリシティ権の侵害にあたると考えられ、利用者と連帯して責任を負う可能性がある、としています
- 2026年9月30日には、声優が自身の声を模倣したAI音声の動画をめぐって起こした訴訟で、東京地裁が声も肖像と同じく人格の象徴であり、パブリシティ権で保護されるとの判断を示したと報じられています(削除の請求自体は退けられました)
- 日本俳優連合は2026年10月15日に「音声に関する生成AI利用ガイドライン」を発表し、学習・生成・公開や利用の各段階で、目的を示して事前に許諾を得ることを求めています
実在の人の声を使うなら、少なくとも次の点を書面で合意しておきます。
- 何に使うか(学習・声のモデルの作成・音声の生成・公開のそれぞれについて)
- 使う範囲(社内だけか、社外にも出すか。媒体、地域)
- 期間と更新、同意を撤回したときの扱い(声のモデルを削除するか)
- 報酬
- 退職や契約終了のあとの扱い
- 生成した音声であることの表示と、なりすましへの対策(公式の発信経路を明示しておくなど)
この記事は一般的な情報の整理で、法的な助言ではありません。実在の人の声を使うサービスを設計するときは、専門家への確認をおすすめします。当社では、キャラクターの声を使う場合は利用規約が明確な音声ライブラリを選び、実在の人の声を使う場合は、本人の同意と権利の確認を前提に設計しています。
判断5:その場で喋るアプリは「待たせない」設計にする
AIキャラクターや音声アシスタントでは、利用者が話しかけてから声が返ってくるまでの時間が、体験の大半を決めます。返答の全文ができるのを待ち、全文を音声にしてから再生していては、長い返答ほど沈黙が長くなります。
基本の形は、返答を文で区切り、一文ずつ合成して、できた順に再生することです。
[LLMが返答を生成]
      │  文末(。!?)で区切る
      ▼
[1文目を合成] ──▶ すぐに再生を始める
[2文目を合成] ──▶ 1文目の再生中に用意しておき、続けて再生
[3文目を合成] ──▶ …当社のAIキャラクターアプリお喋りずんだもんは、この形で作っています。会話の中身はChatGPTが作り、口調の変換と音声合成は端末内で行います。音声合成にはVOICEVOXのコアライブラリ(VOICEVOX CORE)をアプリに組み込み、iPhoneの中で一文ずつ合成しています。1文目の合成が終わった時点で再生を始め、2文目以降は再生している間に裏で合成するため、話し始めるまでの待ち時間は「1文目を合成する時間」だけになります。表情の切り替えも文ごとに行い、悲しい言葉を含む文では悲しい顔に変えています。
この構成には、もう1つの利点があります。音声合成を端末内で行うので、利用者がどれだけ喋らせても、音声合成のAPI料金がかからないことです。LLMのAPI料金はかかりますが、声のぶんの変動費はなくなります。設計全体の考え方は「ChatGPTに“全部”は任せない」で詳しく解説しています。
待ち時間を縮めるための、ほかの工夫も挙げておきます。
- LLMの返答をストリーミングで受け取り、最初の文が届いた時点で合成を始める
- 「うん」「なるほど」のような短い相づちや定型文は、事前に合成してキャッシュしておく
- 1文が長くなりすぎないよう、システムプロンプトで短めの文を指示する。ただし読点ごとに細かく切ると、抑揚が不自然になる
- 利用者が話し始めたら再生を止める割り込み(バージイン)を用意する
- 会話そのものが主役なら、音声を直接やりとりするリアルタイム音声APIも選択肢になる。ただし、キャラクターの声や読みを自分で制御しにくく、料金体系も変わる
日本語の「読み間違い」は別の設計課題
どの方式を選んでも、日本語の音声合成には読み間違いの問題がついて回ります。「1日」を「ついたち」と読むか「いちにち」と読むか、「3本」の読み方、社名や商品名の読み。これは声の品質とは別の問題で、辞書への登録、SSMLでの読みの指定、読みの自動テストといった、アプリ側の対策が必要です。詳しくは「音声合成AIが日本語を読み間違える理由と直し方」で解説しています。
当社の実装例
| アプリ | 音声合成の使い方 | ポイント |
|---|---|---|
| お喋りずんだもん(iPhone・iPad) | ChatGPTの返答を口調変換し、VOICEVOX COREで端末内で一文ずつ合成 | 話し始めの待ち時間を1文目の合成時間に短縮。音声合成のAPI料金がかからない |
| コンセプトカフェシミュレーター(Mac・Steam) | ローカルLLMの会話を、VOICEVOXの15種類の声で読み上げ | LLMも音声合成もMacの中で動くため、オフラインで会話できる |
| LocaNeco(iPhone・iPad) | AIの回答を、iOS標準の音声合成で読み上げ | 文章の言語を判定して声を選ぶ。通信なしで使える |
まとめ
- 最初に、作り置きか、その場で喋るかを決める
- 方式は、クラウドTTS・表現力の高い音声生成・キャラクター音声エンジン・端末内の標準音声合成の4つから、用途で選ぶ
- 料金は月の文字数×単価で見積もる。その場で喋るアプリでは、利用者の数に比例して最大の変動費になりうる
- 商用利用の条件・クレジット表記・声の権利は、作る前に確認する
- その場で喋るアプリは、一文ずつ合成して、できた順に再生する
当社は、音声合成やAIキャラクターを組み込んだアプリを、方式の選定と料金の試算から、実装、App Store / Google Playへの申請まで開発しています。「クラウドと端末内のどちらで合成すべきか」「この利用規模で月いくらになるか」といった検討の段階からのご相談も、お問い合わせからどうぞ。AI機能の開発全般についてはAIアプリ開発のページにまとめています。