「Stable Diffusionを社内で使えるようにしたい」「自社のアプリに画像生成の機能を入れたい」。こうしたご相談が増えています。検索すると導入手順の記事はたくさん見つかりますが、その多くは個人が自分のPCで試すための内容です。
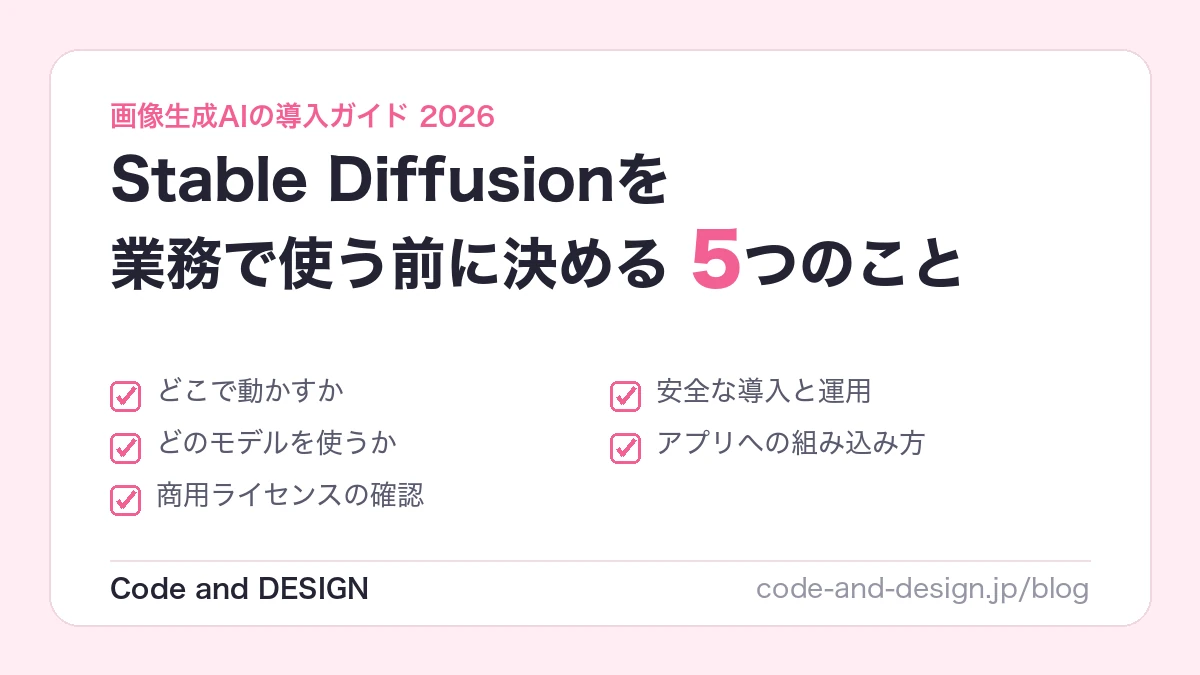
業務で使う場合や、自社のサービスに組み込む場合に本当に問題になるのは、インストールの手順よりも先にある判断です。どこで動かすか、どのモデルを使うか、そのモデルは商用で使ってよいのか、安全に運用できるか、アプリにはどう組み込むか。ここを決めずに始めると、作ったあとでライセンスの問題に気づいたり、社外に見せた画像からプロンプトが漏れたりします。
この記事では、その5つの判断を2026年10月時点の状況で整理します。当社は、iPhoneの中だけで画像を生成するアプリLocaNecoを開発・公開しており、その実装で得た知見もあわせて紹介します。
📌 この記事の3行まとめ
① 最初にどこで動かすか(クラウドのサービス/社内のPC/自社のアプリやサーバー)を決める。業務で使うなら、モデルのライセンスが最初の関門
② 2026年はモデルの選択肢が大きく広がった一方、商用利用の条件はモデルごとにばらばら。派生モデルやLoRAは元のモデルの条件を引き継ぐ
③ 安全対策の要点はsafetensors形式だけを使う・拡張機能を絞る・ネットに公開しない・画像に残るプロンプトを消すの4つ
決めること1:どこで動かすか
画像生成AIの使い方は、大きく3つに分かれます。
| クラウドの画像生成サービス・API | 社内のPCで動かす(ローカル) | 自社のアプリ・サービスに組み込む | |
|---|---|---|---|
| 例 | ChatGPT、Gemini、各社の画像生成API | Stable DiffusionをComfyUIなどで動かす | アプリの機能として画像を生成する |
| 初期費用 | ほぼなし | GPUを積んだPC | 開発費(+サーバー、または端末内で動かす実装) |
| 利用ごとの費用 | 1枚ごと、または月額 | 電気代のみ | 構成による(API料金、GPUサーバー代、端末内ならゼロ) |
| データの行き先 | 事業者のサーバー | 社内にとどまる | 構成による |
| モデルの選択 | 事業者が決める | 自由に選べる(ライセンスの範囲で) | 自由に選べる(ライセンスの範囲で) |
| 向いている使い方 | すぐに高品質な画像がほしい | 社外に出せない素材を扱う、細かく制御したい、大量に作る | 利用者に画像生成の機能を提供する |
すぐに使いたい、少量でよいという場合は、クラウドのサービスで十分です。ローカルで動かす価値が出るのは、未公開の商品画像や社外秘の資料など外に出せない素材を扱うとき、自社の画風やキャラクターに合わせて細かく制御したいとき、そして大量に生成するときです。
決めること2:どのモデルを使うか
「Stable Diffusion」は、もともとStability AIが公開した画像生成モデルの名前ですが、いまでは重みが公開されていて自分の環境で動かせる画像生成モデル全般を指して使われることが多くなっています。2026年10月時点の主なモデルは次のとおりです。
| モデル | 公開 | 規模(パラメータ数) | ライセンス(商用利用) |
|---|---|---|---|
| Stable Diffusion 1.5 | 2022年 | 約1B | CreativeML OpenRAIL-M:商用可(利用制限の条項を引き継ぐ必要あり) |
| SDXL 1.0 | 2023年 | 3.5B | CreativeML OpenRAIL++-M:商用可(同上) |
| Stable Diffusion 3.5(Medium/Large) | 2024年 | 2.5B/8.1B | Stability AI Community License:年間売上100万ドル未満なら無償で商用可。超える場合は有償ライセンス |
| FLUX.1 [schnell] | 2024年 | 12B | Apache 2.0:商用可 |
| FLUX.1 [dev] | 2024年 | 12B | 非商用ライセンス(生成した画像の商用利用は可。収益を生む用途やサービスでのモデルの利用は有償ライセンス) |
| Qwen-Image | 2025年 | 20B | Apache 2.0:商用可 |
| Z-Image-Turbo | 2025年 | 6B | Apache 2.0:商用可 |
| FLUX.2 [dev] | 2025年 | 32B | 非商用ライセンス |
| FLUX.2 [klein] 4B | 2026年 | 4B | Apache 2.0:商用可 |
| Qwen-Image-2.1 | 2026年 | 7B | 研究用ライセンス(研究・評価目的のみ。商用は別契約) |
| FLUX 3 Image Klein | 2026年 | 5.6B | FLUX Kommunity License(非商用に加え、年間売上500万ドル未満の事業者は生成物を商用利用可) |
(2026年10月時点の各モデルの公式配布ページとライセンス文書に基づく概要です。採用前に原文を確認してください。)
この表から分かる2026年の傾向は、新しいモデルほど自由に使えるとは限らないことです。Qwen-Imageは2025年版がApache 2.0だったのに対し、2026年の2.1は研究用ライセンスになりました。FLUXも、大型の[dev]系は非商用のライセンスです。一方で、FLUX.2 [klein] 4BやZ-Image-Turboのように、Apache 2.0で公開されている実用的なモデルもあります。モデルを替えるたびに、ライセンスを確認し直す必要があります。
必要なスペックの目安
ローカルで動かす場合、目安になるのはGPUのメモリ(VRAM)です。
| VRAM | できることの目安 |
|---|---|
| 8GB | SD1.5とSDXLが実用的に動く。大型のモデルは、量子化版(精度を落として軽くしたもの)で試せる程度 |
| 12〜16GB | SDXLが快適。Z-Image-Turbo(16GBに収まる)や、FLUX系の量子化版など、数B〜12B級のモデルも現実的 |
| 24GB以上 | FLUX.1やQwen-Imageの大きめの量子化版も扱える。業務で複数のモデルを使い分けるなら、このクラスが安心 |
Macでも、Apple Silicon搭載機ならGPUを使って動かせます。ただし、同じ価格帯のNVIDIA製GPUを積んだPCより生成が遅いことが多く、大きなモデルほど差が開きます。iPhoneでも画像生成はできますが、現実的なのは数GBに収まる小さめのモデルです(後述のLocaNecoの例を参照)。
決めること3:商用で使ってよいか
業務で使うなら、確認すべきライセンスは3つの層に分かれます。
モデル本体のライセンス
上の表のとおり、ライセンスは大きく4種類あります。
- Apache 2.0など:商用利用を含めて自由に使える
- OpenRAIL系(SD1.5・SDXL):商用利用はできるが、禁止用途などの利用制限を、利用者や派生物に引き継ぐ必要がある
- 売上による条件つき:Stability AI Community License(年間売上100万ドル未満は無償)、FLUX Kommunity License(年間売上500万ドル未満の事業者は生成物を商用利用可)など
- 非商用:FLUX.1 [dev]、FLUX.2 [dev]、Qwen-Image-2.1など
とくに注意したいのがFLUX.1 [dev]です。ライセンスは、生成した画像そのものは商用でも使ってよい(競合するモデルの学習に使うことは除く)としながら、モデルを収益を生む活動や利用者と直接やりとりする用途に使うことは「非商用」に含まれないと明記しています。さらに、違法な生成や権利侵害を防ぐフィルタか人による確認を求め、法令が求める場合はAIで生成したことの表示も求めています。社内の業務で使う場合も含め、有償ライセンスが必要かどうかは、提供元に確認するのが安全です。
派生モデル・LoRAのライセンス
Civitaiなどで配布されている派生モデルや追加学習(LoRA)は、元のモデルのライセンスを引き継いだうえで、独自の条件を加えていることがあります。たとえば、アニメ調の画像で人気のSDXL系派生モデル「NoobAI-XL」は、モデル・派生モデル・生成物の収益化を含む、あらゆる商用利用を禁じています。元のモデルが商用可でも、派生モデルが商用可とは限りません。
実在の人物や既存のキャラクターを再現するLoRAは、ライセンスとは別に、肖像やパブリシティ、著作権、商標の問題を抱えます。業務では使わないのが原則です。
生成した画像と著作権
文化庁の「AIと著作権に関する考え方について」(2024年3月)は、生成・利用の段階で著作権侵害になるかどうかを、既存の著作物との「類似性」と「依拠性」で判断するとしています。作風や画風が似ているだけでは類似性は認められませんが、既存の作品をimg2imgの入力に使うなど、既存の作品を認識したうえで生成した場合は、依拠性が認められうるとされています。
実務では、次のようなルールを社内で決めておくのが現実的です。
- 既存の作品名・キャラクター名・作家名をプロンプトに入れない
- 他人の作品を、img2imgや構図の参照用の入力に使わない
- 公開や納品の前に、既存の作品に似すぎていないかを確認する
- ルールを文書にする(文化庁の「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月)が参考になります)
この記事は一般的な情報の整理で、法的な助言ではありません。個別の判断が必要な場合は、専門家にご確認ください。
決めること4:安全に運用できるか
ローカルの画像生成は、データが社外に出ない反面、自分で安全を守る必要がある仕組みです。最低限、次の6つを押さえます。
| 対策 | なぜ必要か |
|---|---|
| モデルはsafetensors形式だけを使う | .ckpt・.ptなどのpickle形式のファイルは、読み込んだだけで任意のプログラムが実行されうる |
| 拡張機能・カスタムノードを絞り、版を固定する | 2024年6月にはComfyUIのカスタムノード「ComfyUI_LLMVISION」が、ブラウザに保存されたパスワードなどを盗むプログラムを仕込んでいた。同年12月には、画像処理で広く使われるPythonパッケージ「ultralytics」の一部の版に暗号資産の採掘プログラムが混入し、ComfyUIの人気拡張の利用者にも影響が出た |
| インターネットに公開しない | ComfyUIには標準でログイン機能がなく、WebUIも初期設定では認証なしで動く。2026年4月には、インターネットに公開されたComfyUIが1,000台以上見つかり、コードを実行できるノードなどを悪用して暗号資産の採掘やプロキシに使う攻撃が報告された(Censys) |
| 画像に残るプロンプトを消してから社外に出す | AUTOMATIC1111やForgeは生成条件(プロンプトなど)をPNGに書き込み、ComfyUIはワークフロー全体を画像に埋め込むのが既定の動作。社名や未発表の商品名を含むプロンプトが、画像と一緒に社外に出てしまう |
| 業務データと分けた環境で動かす | 万一侵入されても、業務データまで被害が広がらないようにする |
| 公式の配布元から入手し、更新を管理する | 改ざんされたファイルを避け、修正された脆弱性を取り込む |
離れた場所から使いたい場合は、ネットに直接公開するのではなく、VPNや認証つきの中継(リバースプロキシ)を通します。画像のメタデータは、ComfyUIなら起動オプション --disable-metadata で埋め込みを止められます。
決めること5:どのツールで動かし、どう組み込むか
社内で使うなら:ツールの選び方
| ツール | 2026年10月時点の状況 | 向いている使い方 |
|---|---|---|
| ComfyUI | 開発が活発(2026年10月にv0.42)。新しいモデルへの対応が最も早く、公式のデスクトップアプリ(Windows・Mac〈Apple Silicon〉・Linux)もある | 新しいモデルを使いたい、処理をつないで自動化したい、ほかの仕組みからAPIで呼び出したい |
| Forge Neo | 開発が止まった「Stable Diffusion WebUI Forge」の画面を引き継ぎ、開発が続いている派生版。FLUX系、Qwen-Image、Z-Imageなどにも対応 | AUTOMATIC1111に近い画面のまま、新しいモデルも使いたい |
| AUTOMATIC1111 | 最後のリリースは2025年2月(v1.10.1)で、実質的に保守のみ | 既存のSD1.5/SDXLの作業環境を、そのまま維持したい |
これから新しく環境を作るなら、ComfyUIを第一候補にするのがおすすめです。ノードをつなぐ画面に最初は戸惑いますが、作った処理の流れ(ワークフロー)を保存して共有でき、業務の手順として再現しやすいのが利点です。
導入の初期によくあるつまずきも挙げておきます。
| 症状 | 主な原因 | 対処 |
|---|---|---|
| メモリ不足のエラーで止まる | VRAMが足りない | 解像度やバッチ数を下げる、量子化版のモデルを使う |
| 真っ黒な画像になる | SDXLのVAEを半精度(fp16)で動かしたときの数値のあふれ | fp16向けに修正されたVAE(sdxl-vae-fp16-fix)を使うか、VAEを32bitで動かす(AUTOMATIC1111の --no-half-vae) |
| Macで生成が遅い | Apple SiliconのGPUは、画像生成ではNVIDIA製GPUより遅いことが多い | 小さめのモデルや、少ない手順で生成できる高速版(Turbo系)を選ぶ |
| 初回の起動に時間がかかる | ライブラリやモデルのダウンロード | 安定した回線で、時間に余裕をもって準備する |
なお、AUTOMATIC1111には標準で不適切な画像を黒く塗るフィルタはありません。真っ黒な画像が出たら、まずVAEを疑ってください。
自社のアプリやサービスに組み込むなら
利用者に画像生成の機能を提供する場合、構成は大きく3つです。
| 構成 | 仕組み | 費用 | 長所 | 注意点 |
|---|---|---|---|---|
| クラウドAPI | OpenAI・Google・Black Forest Labsなどの画像生成APIを呼ぶ | 1枚あたり数円〜数十円(例:GoogleのNano Banana 2.1は1K画像1枚0.0336ドル) | 品質が高く、すぐに使える | モデルの入れ替わりが速い(OpenAIのgpt-image-1は2026年10月23日に提供終了)。プロンプトと画像は事業者に送られる |
| 自社のGPUサーバー | ComfyUIなどをサーバーで動かし、アプリからAPIで呼ぶ | GPUサーバーの費用(主に固定費) | モデルやLoRAを自由に選べ、データを自社で管理できる | 混雑時の待ち行列、監視、不正利用の対策を自前で用意する |
| 端末内(オンデバイス) | iPhoneやMacの中でモデルを動かす | 推論の費用はかからない | 通信が不要で、プロンプトも画像も端末の外に出ない | 動かせるモデルの大きさに限りがある。数GBのダウンロード、発熱、電池の消費 |
どの構成でも、利用者が自由に画像を作れる機能には、入力と出力のフィルタ、通報の仕組み、利用規約が欠かせません。FLUX.1 [dev]のように、ライセンスでフィルタの導入を求めるモデルもあります。App Storeの審査ガイドラインも、利用者が作るコンテンツを扱うアプリに、不適切な内容のフィルタや通報の仕組みを求めています。
iPhoneアプリなら、Appleの「Image Playground」を呼び出す方法もあります。Apple Intelligenceに対応した端末で、Apple製の画像生成をアプリから使えます。ただし、プログラムから直接画像を作るImageCreatorはiOS 27で非推奨となり、Appleが用意する画面を表示する方式が推奨されています。手軽な反面、画風や出力を細かく制御したい用途には向きません。
当社のLocaNecoでの実装例
当社のLocaNecoは、3つ目の「端末内」の構成で、iPhone・iPadの中だけで画像を生成するアプリです。
- 画像生成エンジンにstable-diffusion.cppを使い、実機ではAppleのGPU(Metal)で計算する
- アプリにはモデルを同梱せず、利用者が選んでダウンロードする。カタログには、iPhoneで安定して動くSD1.5系の3モデル(DreamShaper 8、Realistic Vision V5.1、Stable Diffusion 1.5)を、容量(約2GB)・推奨解像度(512×512)・ライセンス・推奨端末とともに表示している
- カタログのモデルは、すべてsafetensors形式
- SDXL系などの大きなモデルは、利用者がファイルやURLから追加できる(メモリの多い端末向け)。FLUX.2やQwen-Imageのような大型モデルは、iPhoneでは現実的に動かないため掲載していない
端末内で動かす構成は、サーバー費用がかからず、プロンプトも画像も外に出ないのが利点です。一方で、使えるモデルの大きさと速度には、はっきりした限界があります。どの構成が合うかは、画質の要件、利用者の数、扱うデータの性質で決まります。端末内のAIの基礎については、iPhoneでローカルLLMを動かすでも解説しています。
まとめ
- 最初にどこで動かすか(クラウド/社内のPC/アプリやサーバー)を決める
- モデルは、画質だけでなくライセンスで選ぶ。2026年は、新しいモデルほど自由に使えるとは限らない
- 商用利用は、モデル本体・派生モデルやLoRA・生成物の著作権の3層で確認する
- 安全対策は、safetensors形式だけを使う、拡張を絞る、ネットに公開しない、プロンプトを画像に残さない
- 新しく作るならComfyUIが第一候補。アプリに組み込むなら、クラウドAPI・自社サーバー・端末内の3つから、画質・利用者数・データの性質で選ぶ
当社は、画像生成を含むAI機能を、社内で使う環境づくりから、自社のアプリやサービスへの組み込み(クラウドAPI・自社サーバー・端末内)まで開発しています。モデルとライセンスの選定、費用の試算、安全対策の設計の段階からのご相談も、お問い合わせからどうぞ。AI開発の進め方と実績はAIアプリ開発のページにまとめています。